¿Cómo funcionan las redes neuronales artificiales?

Cuando escuchamos hablar de inteligencia artificial, es común que nuestra mente proyecte la imagen de un robot con conciencia propia o de una mente electrónica capaz de razonar como un ser humano. Sin embargo, en el núcleo de la tecnología que está transformando nuestra realidad —desde los traductores automáticos hasta el reconocimiento de rostros en un teléfono— no hay una "mente", sino una arquitectura matemática inspirada en la biología. Estamos hablando de las redes neuronales artificiales.
Una red neuronal artificial es un modelo computacional diseñado para procesar información de una manera similar a como lo hace el cerebro humano. En lugar de seguir un conjunto de instrucciones rígidas y lineales (si ocurre A, entonces haz B), estas redes aprenden a reconocer patrones complejos a partir de grandes cantidades de datos. Su objetivo principal es encontrar relaciones ocultas en la información para realizar tareas como clasificar imágenes, predecir tendencias o generar texto de forma coherente.
A lo largo de este artículo, exploraremos cómo se estructuran estas redes, desde sus unidades más básicas hasta la complejidad de sus capas, y cómo es que un sistema basado en matemáticas puras puede "aprender" a distinguir un gato de un perro o a entender el lenguaje humano. Entender su funcionamiento nos permitirá desmitificar la idea de una inteligencia mágica y comprender la realidad de un proceso estadístico y computacional extremadamente sofisticado.
La inspiración biológica y la unidad básica: la neurona artificial
El concepto de red neuronal nace de la observación de la naturaleza. En nuestro cerebro, la unidad fundamental es la neurona biológica, una célula que recibe señales eléctricas de otras neuronas, las procesa y, si la señal es lo suficientemente fuerte, la transmite hacia adelante. Este sistema de comunicación masiva y conectada es lo que nos permite aprender, recordar y percibir el mundo.
En el ámbito de la tecnología, intentamos replicar este proceso mediante una abstracción matemática llamada "neurona artificial" o perceptron. Una neurona artificial no es más que una función que realiza una operación aritmética. Para entenderlo, podemos imaginar que esta unidad recibe varias entradas de información, cada una con un valor determinado.
El proceso de la neurona artificial consta de tres pasos esenciales:
- Los pesos: No todas las entradas son igual de importantes. Por ejemplo, si queremos decidir si un objeto es una fruta, el color es un dato relevante, pero la textura también lo es. La red asigna un "peso" a cada entrada; un peso alto significa que esa característica es muy determinante para el resultado, mientras que un peso bajo indica que es menos relevante.
- La suma ponderada: La neurona multiplica cada entrada por su peso correspondiente y suma todos esos resultados. A esta suma se le suele añadir un valor de ajuste, llamado sesgo (o bias), que permite desplazar el resultado para que la neurona sea más o menos propensa a activarse.
- La función de activación: Una vez obtenida la suma, la neurona debe decidir si envía una señal o no. Aquí entra la función de activación, que actúa como un filtro o interruptor. Transforma el número resultante en un nuevo valor (por ejemplo, un número entre 0 y 1) que determina la intensidad de la señal que se enviará a la siguiente capa.
Aunque una sola neurona es capaz de realizar tareas extremadamente simples, carece de la capacidad de entender el mundo. La verdadera magia ocurre cuando conectamos miles o millones de estas unidades en estructuras organizadas.
La arquitectura de la red: capas y conexiones
Una red neuronal no es un grupo desordenado de neuronas, sino una estructura organizada en capas. Esta disposición es lo que permite que la información se transforme gradualmente desde datos brutos hasta conceptos abstractos. Para visualizarlo, podemos dividir la arquitectura en tres secciones principales:
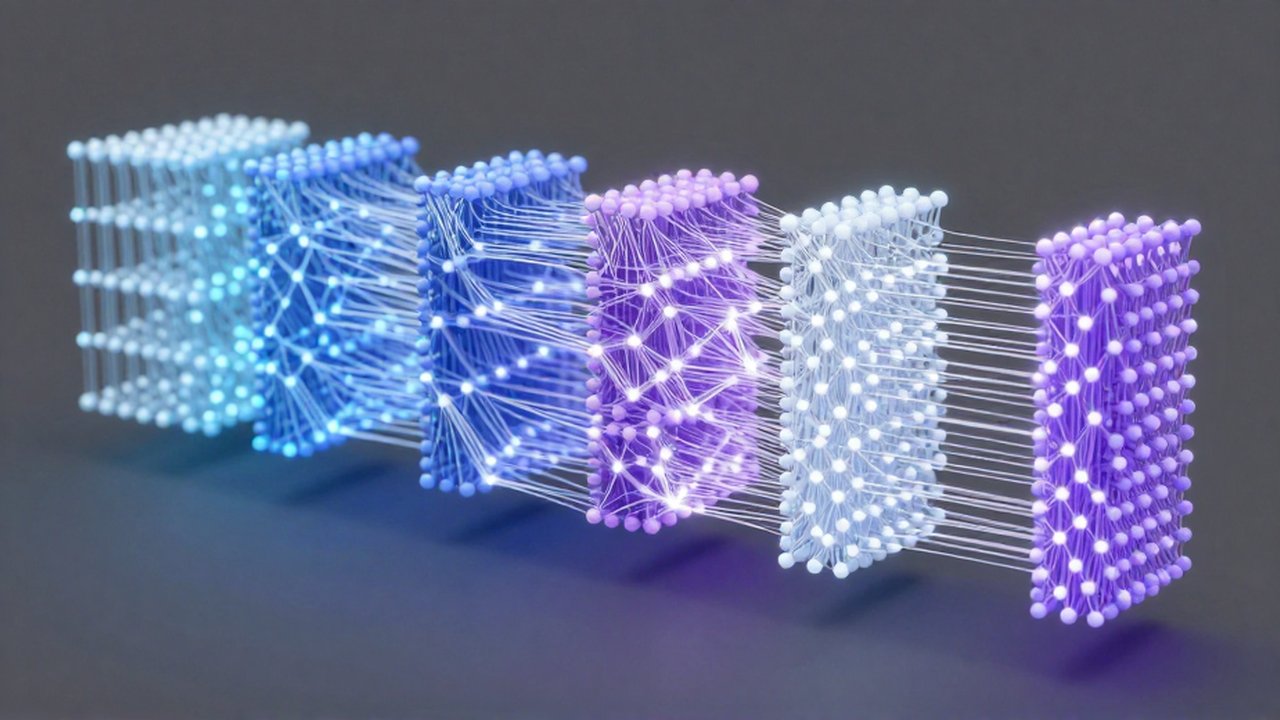
La capa de entrada: Es la puerta de acceso a la red. Si le estamos pidiendo a una red que analice una fotografía digital, la capa de entrada recibirá los valores de los píxeles (su brillo y color). Si la red analiza datos meteorológicos, la entrada serán las temperaturas, la presión y la humedad.
Las capas ocultas: Aquí es donde reside la verdadera potencia del aprendizaje. Una red puede tener una, dos o cientos de capas ocultas entre la entrada y la salida. Se llaman "ocultas" porque no interactúan directamente con el mundo exterior, sino que procesan la información interna que reciben de la capa anterior. En las primeras capas ocultas, la red suele detectar patrones muy simples, como bordes o líneas en una imagen. A medida que la información avanza hacia las capas más profundas, los patrones se vuelven más complejos: primero formas geométricas, luego partes de un objeto y, finalmente, el objeto completo.
La capa de salida: Es el destino final del proceso. Aquí la red ofrece su conclusión. Si estamos ante un problema de clasificación, la capa de salida podría tener tres neuronas que representan "perro", "gato" o "pájaro". La neurona que reciba el valor más alto será la respuesta de la red.
Comprender estas diferencias es fundamental para entender por qué la tecnología actual es tan potente. La capacidad de añadir capas es lo que define el llamado Deep Learning o aprendizaje profundo. Cuantas más capas tenga una red, más capaz será de entender jerarquías de conceptos, pero también requerirá una potencia de cálculo mucho mayor.
| Característica | Red Neuronal Simple | Red Neuronal Profunda (Deep Learning) |
|---|---|---|
| Número de capas ocultas | Una o muy pocas. | Muchas (decenas o cientos). |
| Capacidad de abstracción | Baja; detecta relaciones lineales y simples. | Muy alta; detecta patrones complejos y abstractos. |
| Uso de datos | Funciona bien con volúmenes de datos moderados. | Requiere cantidades masivas de datos para ser efectiva. |
| Complejidad de cómputo | Baja; puede ejecutarse en equipos sencillos. | Muy alta; requiere procesadores especializados (GPU). |
| Ejemplo de aplicación | Predicciones de ventas básicas. | Reconocimiento de voz, conducción autónoma. |
El mecanismo de aprendizaje: error y corrección
Una de las preguntas más frecuentes es: ¿cómo sabe la red que se ha equivocado y cómo mejora? Una red neuronal no nace con conocimiento; empieza con pesos y sesgos asignados de forma aleatoria, lo que significa que, al principio, sus respuestas serán puro ruido sin sentido. El aprendizaje es, en realidad, un proceso de ajuste constante mediante el error.
Este proceso se divide en dos fases que se repiten miles de veces durante el entrenamiento:
La propagación hacia adelante (Forward Propagation): La información entra por la capa de entrada, viaja a través de las capas ocultas mediante multiplicaciones y sumas, y llega a la capa de salida entregando un resultado. Por ejemplo, la red recibe la imagen de un número "7" y, debido a sus pesos aleatorios, dice con un 60% de confianza que es un "3".
La retropropagación (Backpropagation): Aquí es donde ocurre el aprendizaje. Primero, se calcula la diferencia entre la respuesta de la red y la respuesta correcta (la "etiqueta" real). Esta diferencia se llama función de pérdida. Una vez que sabemos cuánto nos hemos equivocado, el algoritmo de retropropagación viaja hacia atrás, desde la salida hasta la entrada, recorriendo la red. Su misión es identificar qué neuronas y qué pesos contribuyeron más al error.
Para corregir el error, la red utiliza un método llamado descenso del gradiente. Imagine que está en la cima de una montaña en medio de la niebla y quiere bajar al valle (el punto de error mínimo). Como no puede ver el camino, da pequeños pasos en la dirección en la que el suelo desciende más pronunciadamente. En la red, esto significa ajustar ligeramente los pesos de cada neurona para que, la próxima vez que vea esa misma información, el error sea un poco menor.
Este ciclo de intentar, fallar, calcular el error y ajustar los pesos se repite con millones de ejemplos hasta que la red alcanza un nivel de precisión aceptable. Es un proceso puramente matemático de optimización.
Desafíos y limitaciones del modelo
A pesar de su extraordinaria capacidad, las redes neuronales no son infalibles y presentan desafíos técnicos y conceptuales que los investigadores intentan resolver constantemente.
Uno de los problemas más conocidos es el sobreajuste (overfitting). Esto ocurre cuando la red se vuelve "demasiado buena" memorizando los datos de entrenamiento. En lugar de aprender los conceptos generales (por ejemplo, qué hace que un gato sea un gato), la red memoriza los detalles específicos de las fotos que ha visto (como el color del fondo o una mancha en la pared). Como resultado, la red funciona de maravilla con los datos que ya conoce, pero falla estrepitosamente cuando se le presenta una imagen nueva de un gato en un entorno diferente.
Otro reto es la "caja negra". A medida que las redes se vuelven más profundas y complejas, se vuelve extremadamente difícil para los seres humanos comprender exactamente por qué la red ha tomado una decisión específica. En sectores críticos como la medicina o la justicia, esta falta de interpretabilidad es un problema serio, ya que no basta con que un sistema dé un diagnóstico; es necesario entender la lógica detrás de él.
Finalmente, la dependencia de los datos es absoluta. Una red neuronal solo es tan buena como los datos con los que ha sido entrenada. Si los datos contienen sesgos (por ejemplo, si solo se entrenan sistemas de reconocimiento facial con personas de una determinada etnia), la red replicará y amplificará esos sesgos, generando resultados injustos o erróneos para otros grupos.
Preguntas frecuentes
¿Las redes neuronales pueden pensar realmente?
No en el sentido biológico o consciente. No tienen deseos, intenciones ni comprensión del mundo. Lo que hacen es realizar cálculos estadísticos de altísima complejidad para encontrar patrones en los datos. Su "inteligencia" es una simulación matemática de la capacidad de procesar información.
¿Por qué se necesita tanta potencia de cálculo para la inteligencia artificial?
Porque el proceso de entrenamiento implica realizar miles de millones de multiplicaciones y sumas de forma simultánea. Durante la retropropagación, cada uno de los pesos de cada neurona debe ser ajustado, lo que requiere una capacidad de procesamiento masivo que las CPUs tradicionales no pueden gestionar de forma eficiente, por lo que se utilizan tarjetas gráficas (GPU), diseñadas para hacer muchos cálculos sencillos al mismo tiempo.
¿Qué diferencia hay entre inteligencia artificial y aprendizaje profundo?
La inteligencia artificial es el concepto amplio de máquinas que imitan funciones cognitivas. El aprendizaje profundo (deep learning) es una técnica específica dentro de la inteligencia artificial que utiliza redes neuronales con muchas capas ocultas para resolver problemas complejos. Es decir, todo el aprendizaje profundo es inteligencia artificial, pero no toda la inteligencia artificial utiliza redes neuronales profundas.
¿Podrán las redes neuronales reemplazar la inteligencia humana?
Es un tema de debate abierto. Actualmente, las redes neuronales son excelentes en tareas específicas (como jugar al ajedrez o transcribir voz), pero carecen de la inteligencia general, el sentido común y la capacidad de aprender de un solo ejemplo que poseemos los seres humanos. La transición de una inteligencia especializada a una inteligencia general es uno de los mayores retos de la ciencia actual.
Deja una respuesta
Entradas relacionadas