Por qué el aprendizaje profundo requiere tantos datos

En la actualidad, es casi imposible pasar un día sin interactuar con alguna forma de inteligencia artificial. Desde los sistemas que filtran el correo no deseado hasta los algoritmos que nos recomiendan una canción o identifican un rostro en una fotografía, la tecnología parece haber adquirido una capacidad casi humana para reconocer patrones. Sin embargo, detrás de esta aparente "magia" se encuentra un motor matemático extremadamente voraz: el aprendizaje profundo o deep learning.
A diferencia de la inteligencia artificial tradicional, que dependía de reglas lógicas escritas paso a paso por ingenieros, el aprendizaje profundo se basa en redes neuronales artificiales. Estas son estructuras de software inspiradas vagamente en el funcionamiento de las neuronas biológicas, diseñadas para aprender de forma autónoma. El problema fundamental es que, para que estas redes aprendan a distinguir un gato de un perro, o a traducir un texto con fluidez, no basta con darles un par de ejemplos. Necesitan millones, a veces miles de millones, de ejemplos.
Este artículo explora la razón técnica y conceptual de este hambre de información. Analizaremos por qué la estructura de las redes neuronales exige tal volumen de datos, la diferencia entre aprender una regla y aprender un patrón, y los desafíos que plantea esta necesidad para el futuro de la tecnología. En esencia, entenderemos que el aprendizaje profundo no es inteligente de forma innata; es, más bien, un proceso de estadística masiva que requiere una cantidad ingente de materia prima para evitar errores de interpretación.
La arquitectura de las redes neuronales y la búsqueda de patrones
Para comprender la necesidad de datos, primero debemos entender qué es lo que realmente está haciendo una máquina cuando "aprende". En la programación clásica, si querías que un ordenador identificara un círculo, le dabas una definición geométrica: "una figura cerrada donde todos los puntos están a la misma distancia del centro". El ordenador simplemente aplicaba la regla. En el aprendizaje profundo, no le damos la definición. Le damos un millón de imágenes de círculos y le decimos: "esto es un círculo".
El aprendizaje profundo utiliza capas de nodos o "neuronas" artificiales. La primera capa recibe los datos brutos (por ejemplo, los píxeles de una imagen). Cada capa sucesiva analiza aspectos cada vez más abstractos. La primera capa puede detectar simples líneas o bordes; la segunda, formas geométricas básicas; la tercera, estructuras más complejas como ojos o narices; y las capas finales, el objeto completo.
Este proceso de descomposición requiere que la red ajuste constantemente sus conexiones internas, llamadas "pesos". Un peso determina cuánto influye una señal sobre la siguiente neurona. Al principio, estos pesos son aleatorios y la red no sabe nada. Cada vez que la red comete un error, se ajustan los pesos ligeramente para reducir ese error en el siguiente intento. Este ajuste es un proceso de optimización matemática.
El problema es que, con pocos datos, la red puede encontrar una solución que funcione para esos pocos ejemplos pero que sea totalmente errónea para el resto del mundo. Si solo le mostramos tres fotos de círculos rojos, la red podría concluir erróneamente que para que algo sea un círculo debe ser necesariamente rojo. Para evitar este error, necesita ver círculos de todos los colores, tamaños, grosores de línea y condiciones de iluminación. Cuantos más parámetros (conexiones) tiene una red, más "espacio" de posibilidades debe cubrir con datos para no perderse en la complejidad.
El problema del sobreajuste y la generalización
Uno de los conceptos más críticos en la ciencia de datos es la diferencia entre memorizar y generalizar. En el aprendizaje profundo, cuando una red tiene demasiada capacidad pero recibe muy pocos datos, cae en un fenómeno llamado sobreajuste o overfitting.
El sobreajuste ocurre cuando la red neuronal se vuelve tan extremadamente precisa en los datos que ha visto que, en lugar de aprender la esencia del concepto, termina memorizando el ruido o los detalles irrelevantes de esos ejemplos específicos. Imagina a un estudiante que, en lugar de entender las reglas de la gramática, se memoriza palabra por palabra todos los ejercicios del libro de texto. Si en el examen le cambian una sola coma o una palabra, el estudiante fallará porque no ha aprendido la lógica, solo ha memorizado una secuencia.
La meta de la inteligencia artificial es la generalización: la capacidad de aplicar lo aprendido a situaciones nuevas que nunca se han visto antes. Para que una red neuronal generalice bien, necesita una muestra que sea lo suficientemente diversa como para representar la realidad de forma estadística.
| Concepto | Descripción | Resultado si hay pocos datos |
|---|---|---|
| Generalización | La capacidad de aplicar reglas aprendidas a datos nuevos y desconocidos. | El objetivo ideal de cualquier modelo. |
| Sobreajuste (Overfitting) | Cuando el modelo memoriza los detalles y el ruido de los datos de entrenamiento. | El modelo falla estrepitosamente con datos nuevos. |
| Subajuste (Underfitting) | Cuando el modelo es demasiado simple para entender la complejidad de los datos. | El modelo es incapaz de aprender incluso los datos que ya conoce. |
Para evitar el sobreajuste, los ingenieros utilizan técnicas de regularización y, sobre todo, inyectan más datos. La abundancia de información actúa como un ancla de realidad: obliga a la red a ignorar los detalles accidentales (como el color del fondo de una foto) y a centrarse en los rasgos estructurales que son constantes en todos los ejemplos.
La escala de la complejidad en el mundo real
Si el aprendizaje profundo se limitara a tareas sencillas, como clasificar números escritos a mano, no necesitaríamos tanto volumen de datos. Sin embargo, el mundo real no es una estructura ordenada de reglas matemáticas simples. La realidad es estocástica, lo que significa que está llena de incertidumbre, variaciones y casos excepcionales.
Cuando intentamos que una máquina entienda el lenguaje natural, nos enfrentamos a la enorme complejidad de la semántica, la ironía, el contexto y las sutilezas culturales. Una palabra puede cambiar de significado según la frase en la que se encuentre. Para que una red neuronal capte estas sutilezas, debe procesar trillones de palabras para entender las probabilidades estadísticas de que una palabra siga a otra en diferentes contextos.
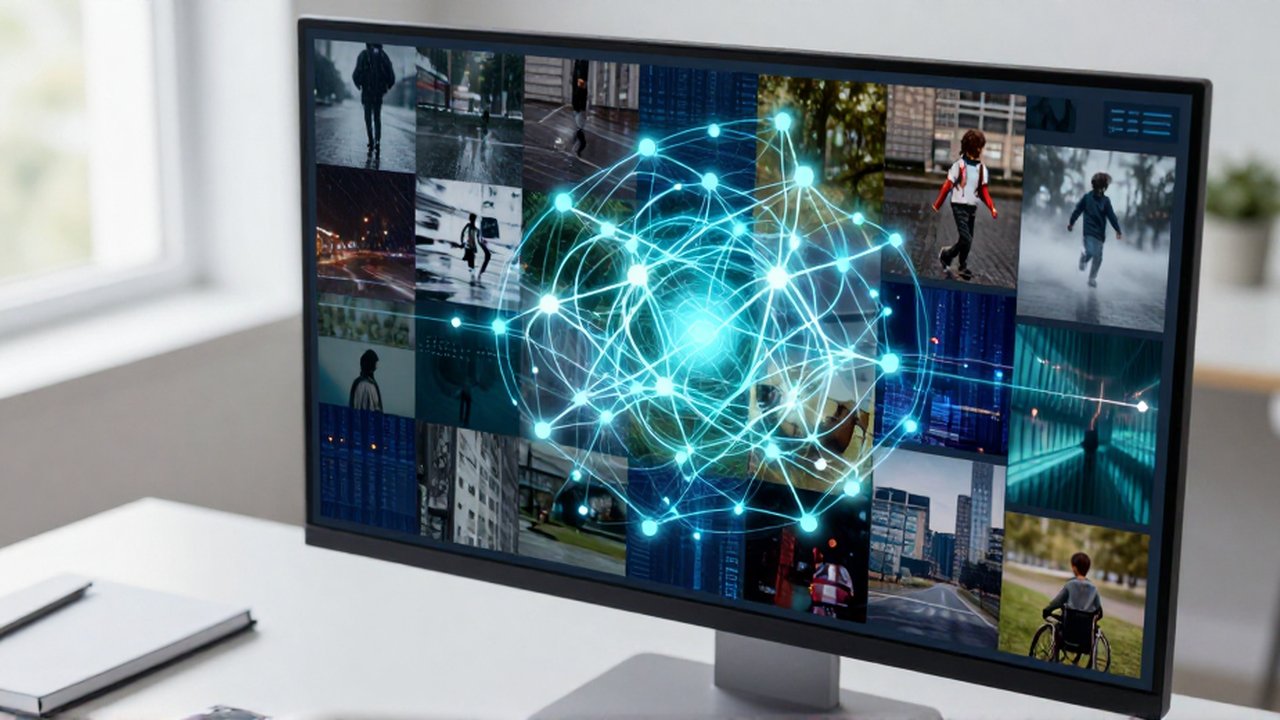
Lo mismo ocurre con la visión por computador. Para que un coche autónomo sea seguro, no basta con que reconozca un "peatón" en un día soleado. Debe reconocerlo bajo la lluvia, de noche, con niebla, si lleva un paraguas, si es un niño corriendo o si es una persona en silla de ruedas. La variedad de estas situaciones es prácticamente infinita, y la única forma de que la red estadística cubra ese espectro de posibilidades es mediante un entrenamiento masivo.
La escala de los datos actuales se mide en petabytes de información. Esto ha creado una nueva dinámica en la tecnología: la ventaja competitiva ya no reside solo en tener el mejor algoritmo (el código), sino en quién posee el conjunto de datos más grande, limpio y diverso.
Desafíos y el futuro de la eficiencia de datos
A pesar del éxito del modelo de "más datos es mejor", existe una corriente creciente de investigación que busca romper esta dependencia. Se ha observado que los seres humanos somos extremadamente eficientes en el aprendizaje: un niño puede ver un elefante una sola vez y ser capaz de reconocerlo para siempre, sin importar el ángulo o la iluminación. Una red neuronal, en cambio, requeriría miles de imágenes.
Esta disparidad ha abierto varios frentes de investigación tecnológica:
- Aprendizaje por transferencia (Transfer Learning): Esta técnica consiste en tomar una red que ya ha sido entrenada con un conjunto de datos gigantesco (por ejemplo, millones de imágenes de objetos generales) y "reentrenarla" con un conjunto de datos mucho más pequeño para una tarea específica (por ejemplo, detectar enfermedades en radiografías). La red ya sabe qué es una línea, un borde y una forma, por lo que solo tiene que aprender las particularidades de la tarea médica.
- Aprendizaje autosupervisado: En lugar de que humanos etiqueten cada imagen o frase (un proceso costoso y lento), se intenta que la máquina aprenda de los datos sin etiquetas, ocultando partes de la información y tratando de adivinarlas. Esto permite aprovechar la inmensidad de internet sin necesidad de supervisión humana constante.
- Aprendizaje con pocos ejemplos (Few-shot learning): El objetivo es diseñar arquitecturas más parecidas a la biología humana que puedan extraer reglas generales de muy pocos ejemplos, mejorando la eficiencia del modelo.
¿Es posible que la inteligencia artificial deje de necesitar tantos datos algún día?
Es una de las grandes preguntas de la computación. La hipótesis actual es que, aunque mejoraremos la eficiencia, la base de la inteligencia artificial moderna seguirá siendo estadística. La complejidad del mundo físico y social es tan alta que siempre habrá una necesidad de escala para garantizar la precisión y evitar errores catastróficos.
¿Por qué no basta con usar datos de internet si ya hay tantos?
No todo el dato es útil. Los datos de internet suelen ser "sucios": contienen errores, sesgos culturales, información contradictoria y, sobre todo, mucha redundancia. Además, para que una red aprenda correctamente, los datos deben estar bien organizados o procesados de una manera que la máquina pueda interpretar de forma coherente. La calidad del dato es, a menudo, más importante que la cantidad.
¿Qué papel juega la potencia de cálculo en esta necesidad de datos?
Existe una relación directa. A medida que aumentamos la cantidad de datos, necesitamos más capacidad de procesamiento para que la red pueda realizar los billones de cálculos necesarios para ajustar sus pesos. Por eso, el desarrollo del aprendizaje profundo ha ido de la mano con la evolución de las tarjetas gráficas (GPU) y otros procesadores especializados, que permiten procesar esos datos en paralelo de forma mucho más rápida que un procesador convencional.
Deja una respuesta
Entradas relacionadas